IBM, Mitsubishi Chemical en Keio trainen quantumalgoritme rechtstreeks op 70 qubits
IBM Quantum, Mitsubishi Chemical, Keio University en NVIDIA trainden een generatieve quantum-eigensolver direct op 70-qubitshardware, met tot 72 keer minder quantumpoorten dan de klassieke aanpak en toepassing op EUV-fotoresistmolecules.
- Gepubliceerd
- Bijgewerkt
- 2 min lezen
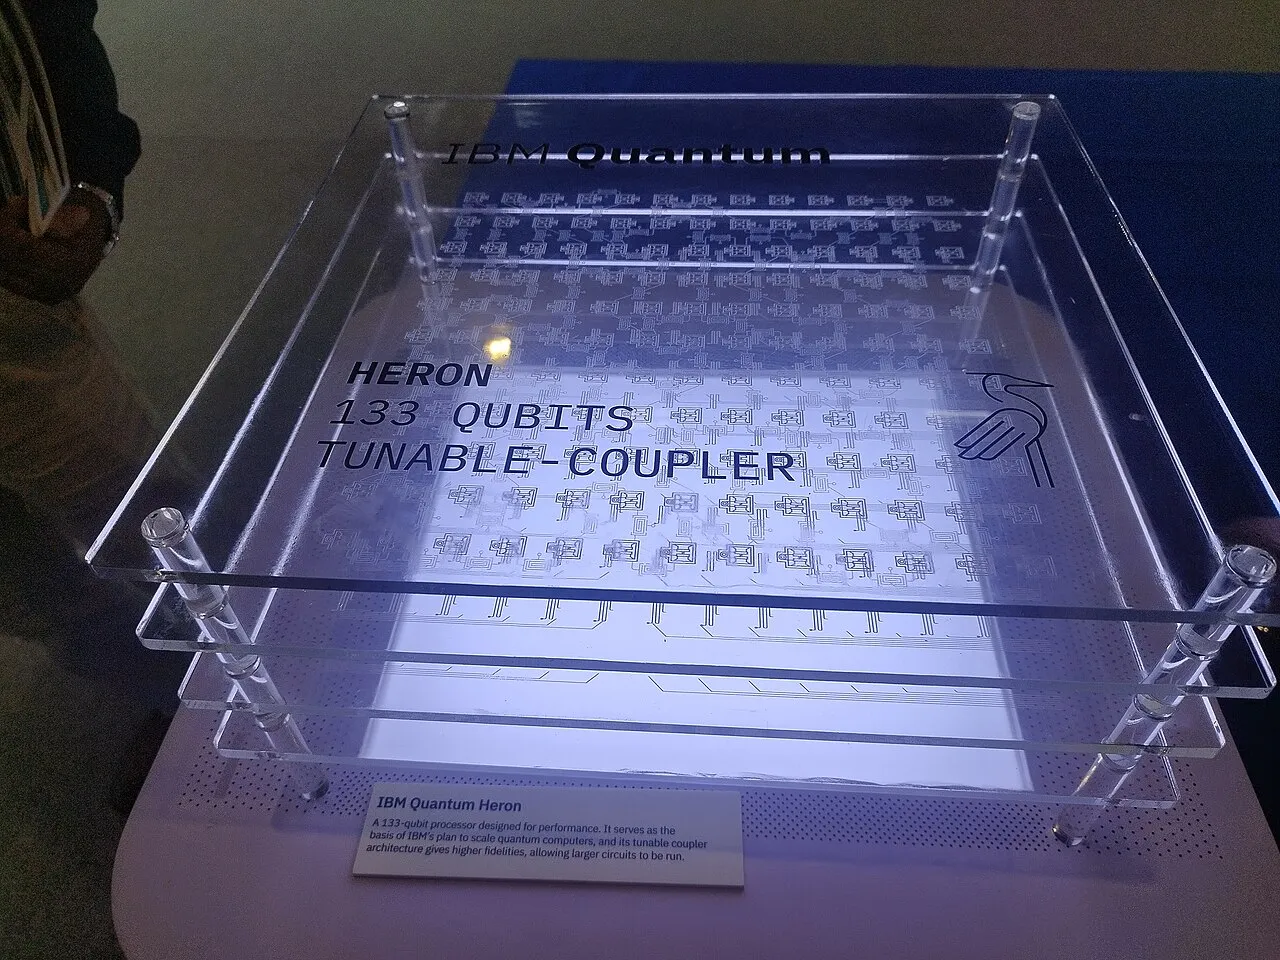
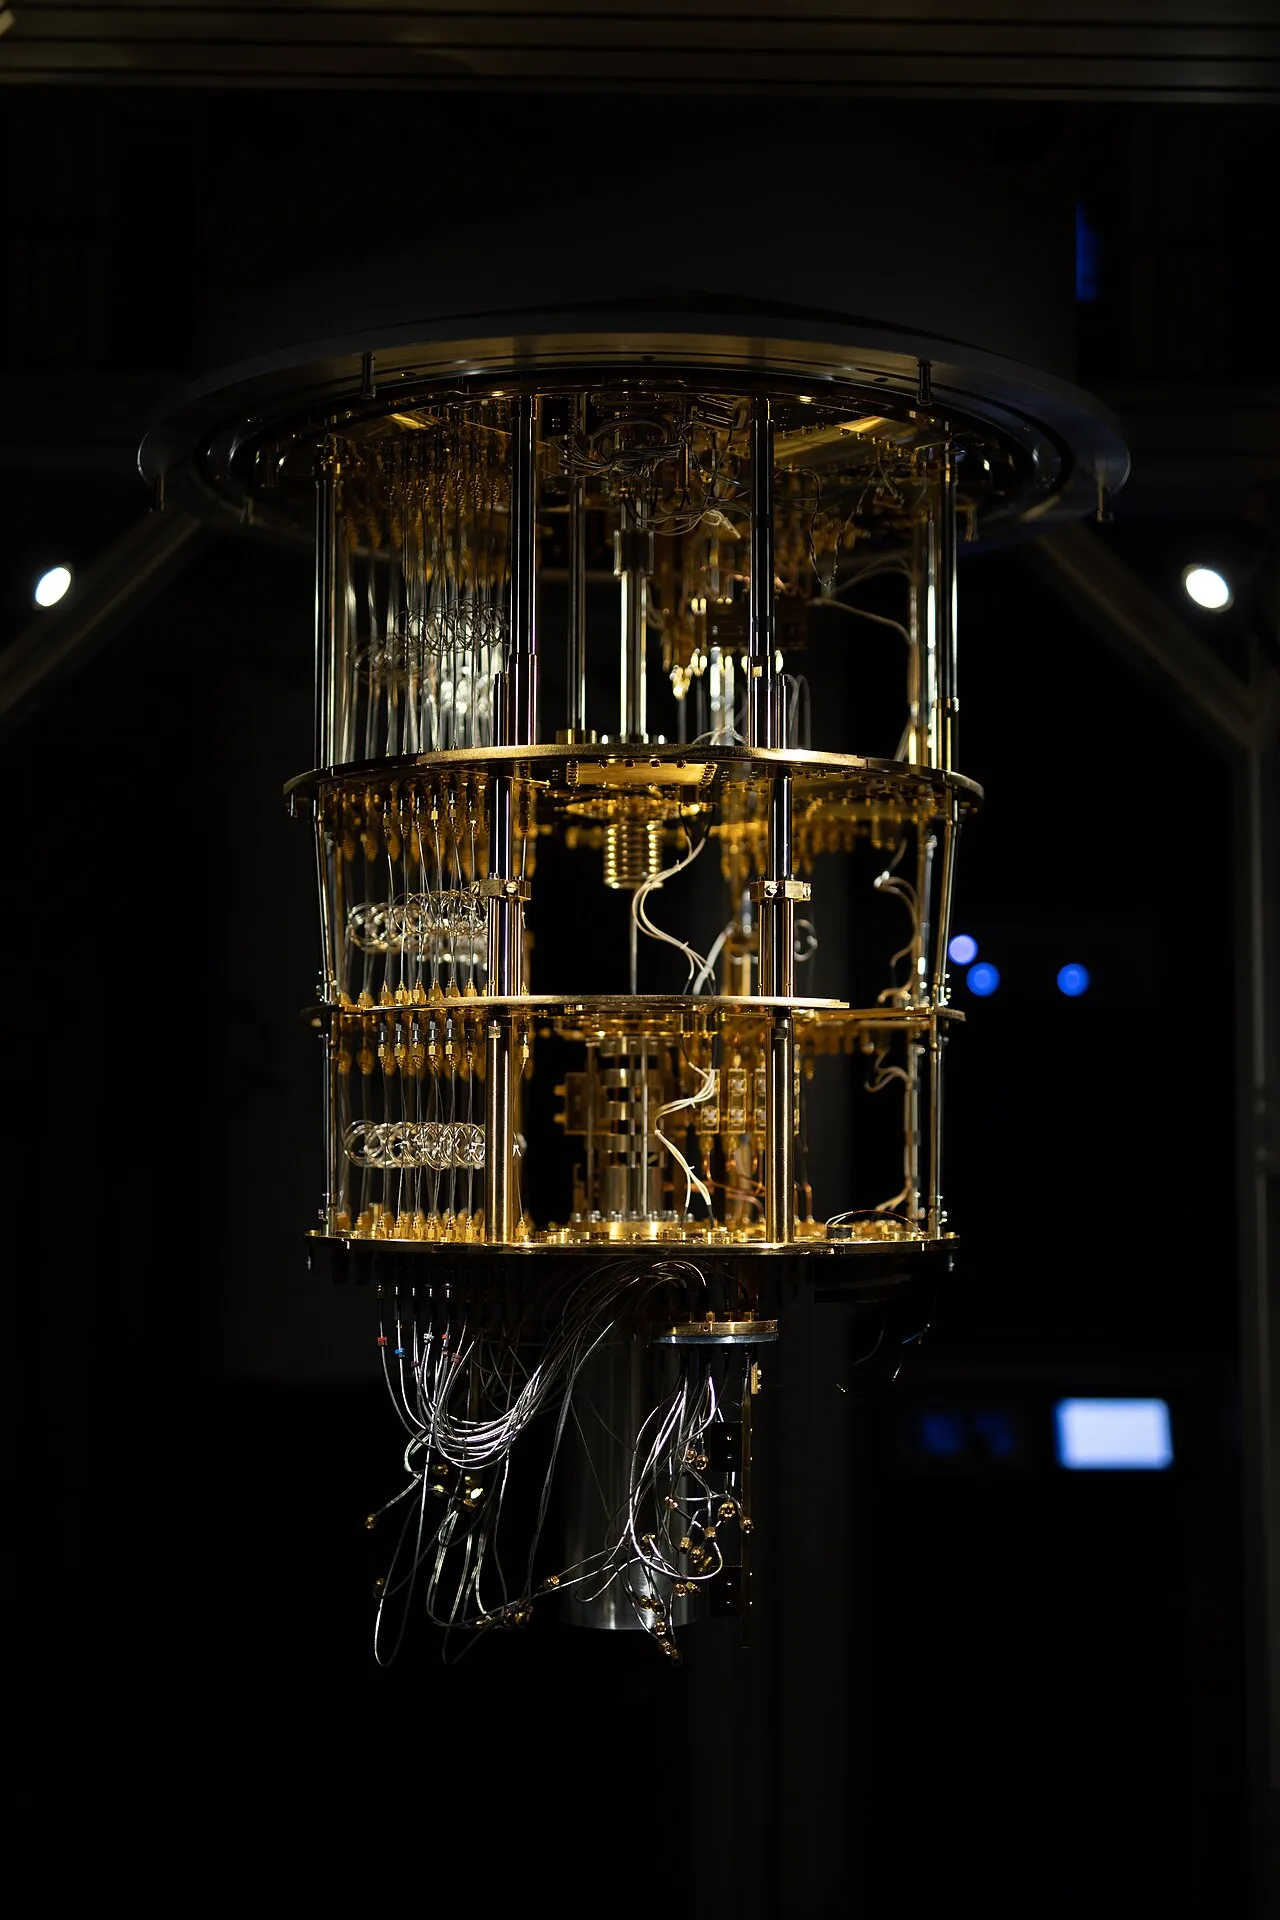
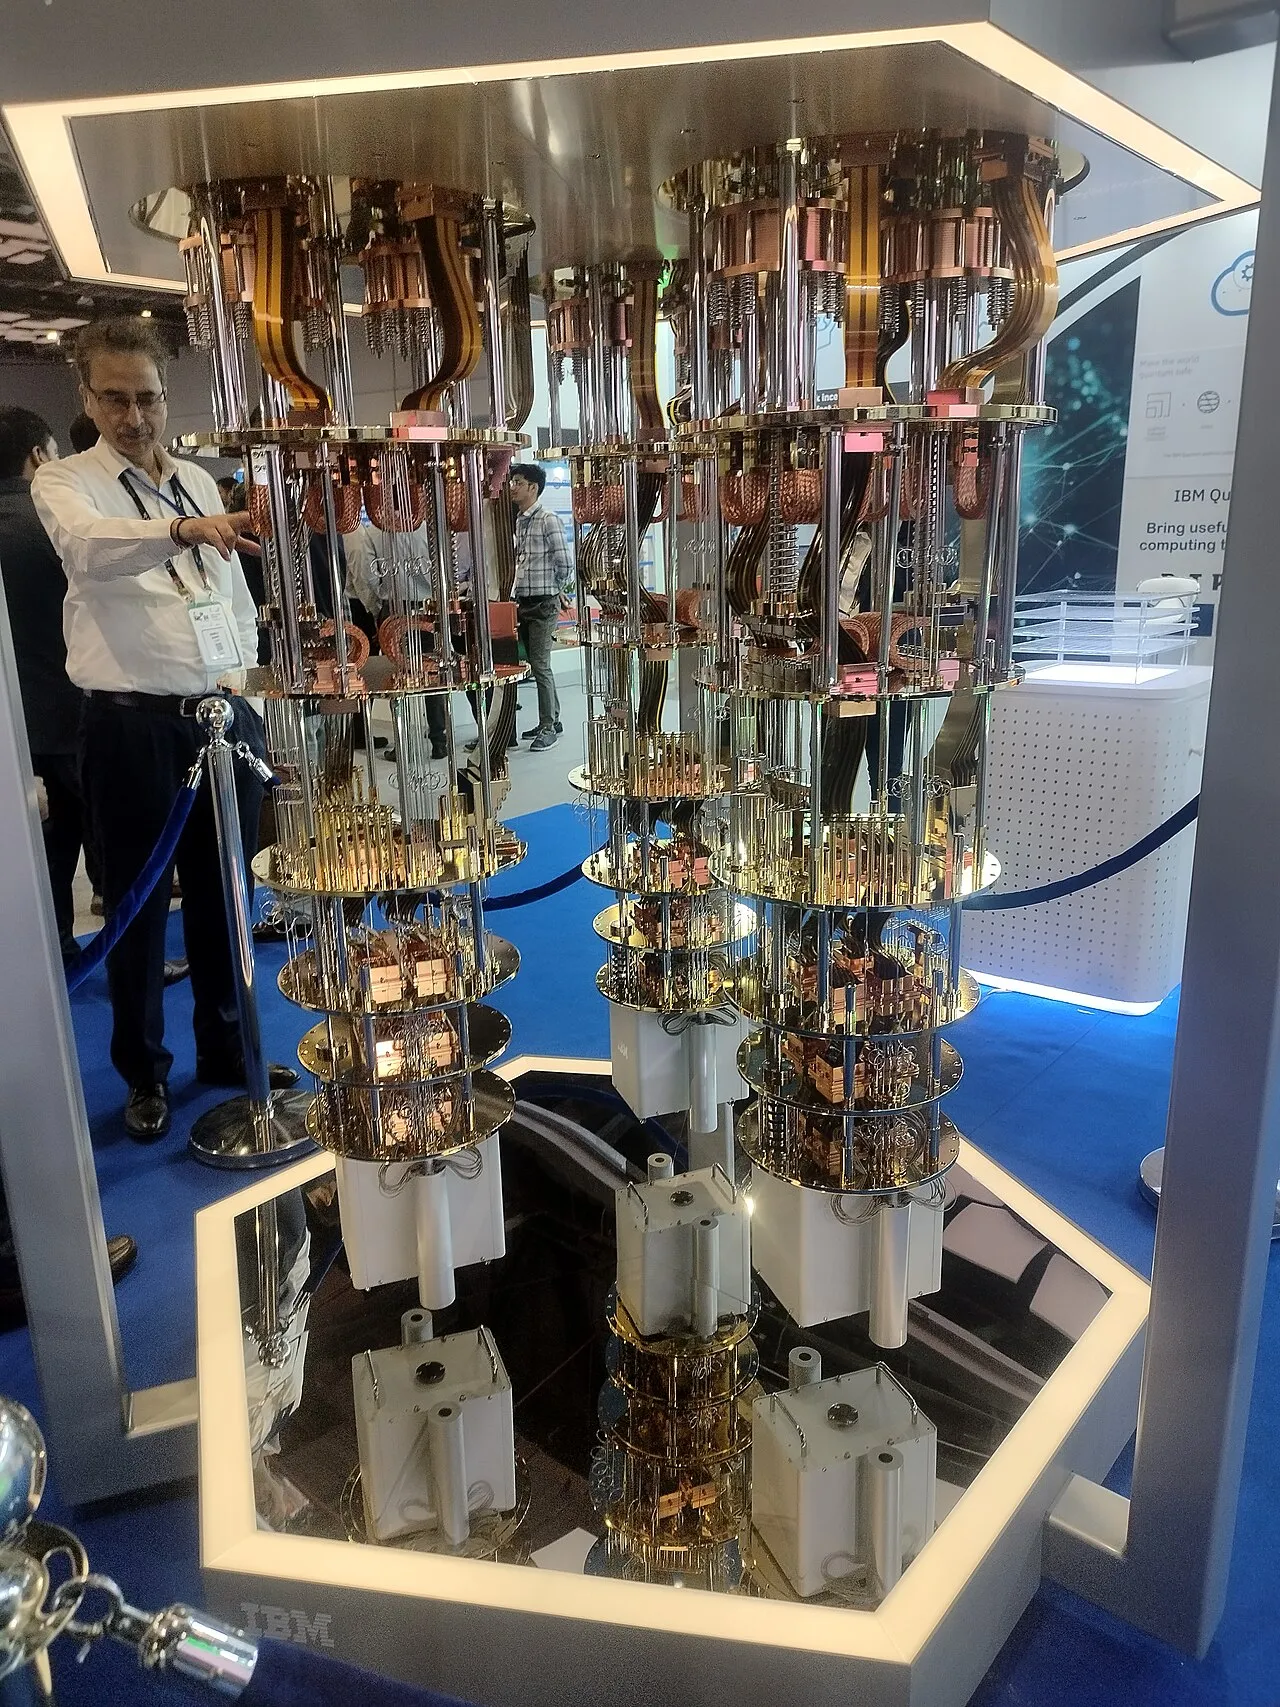
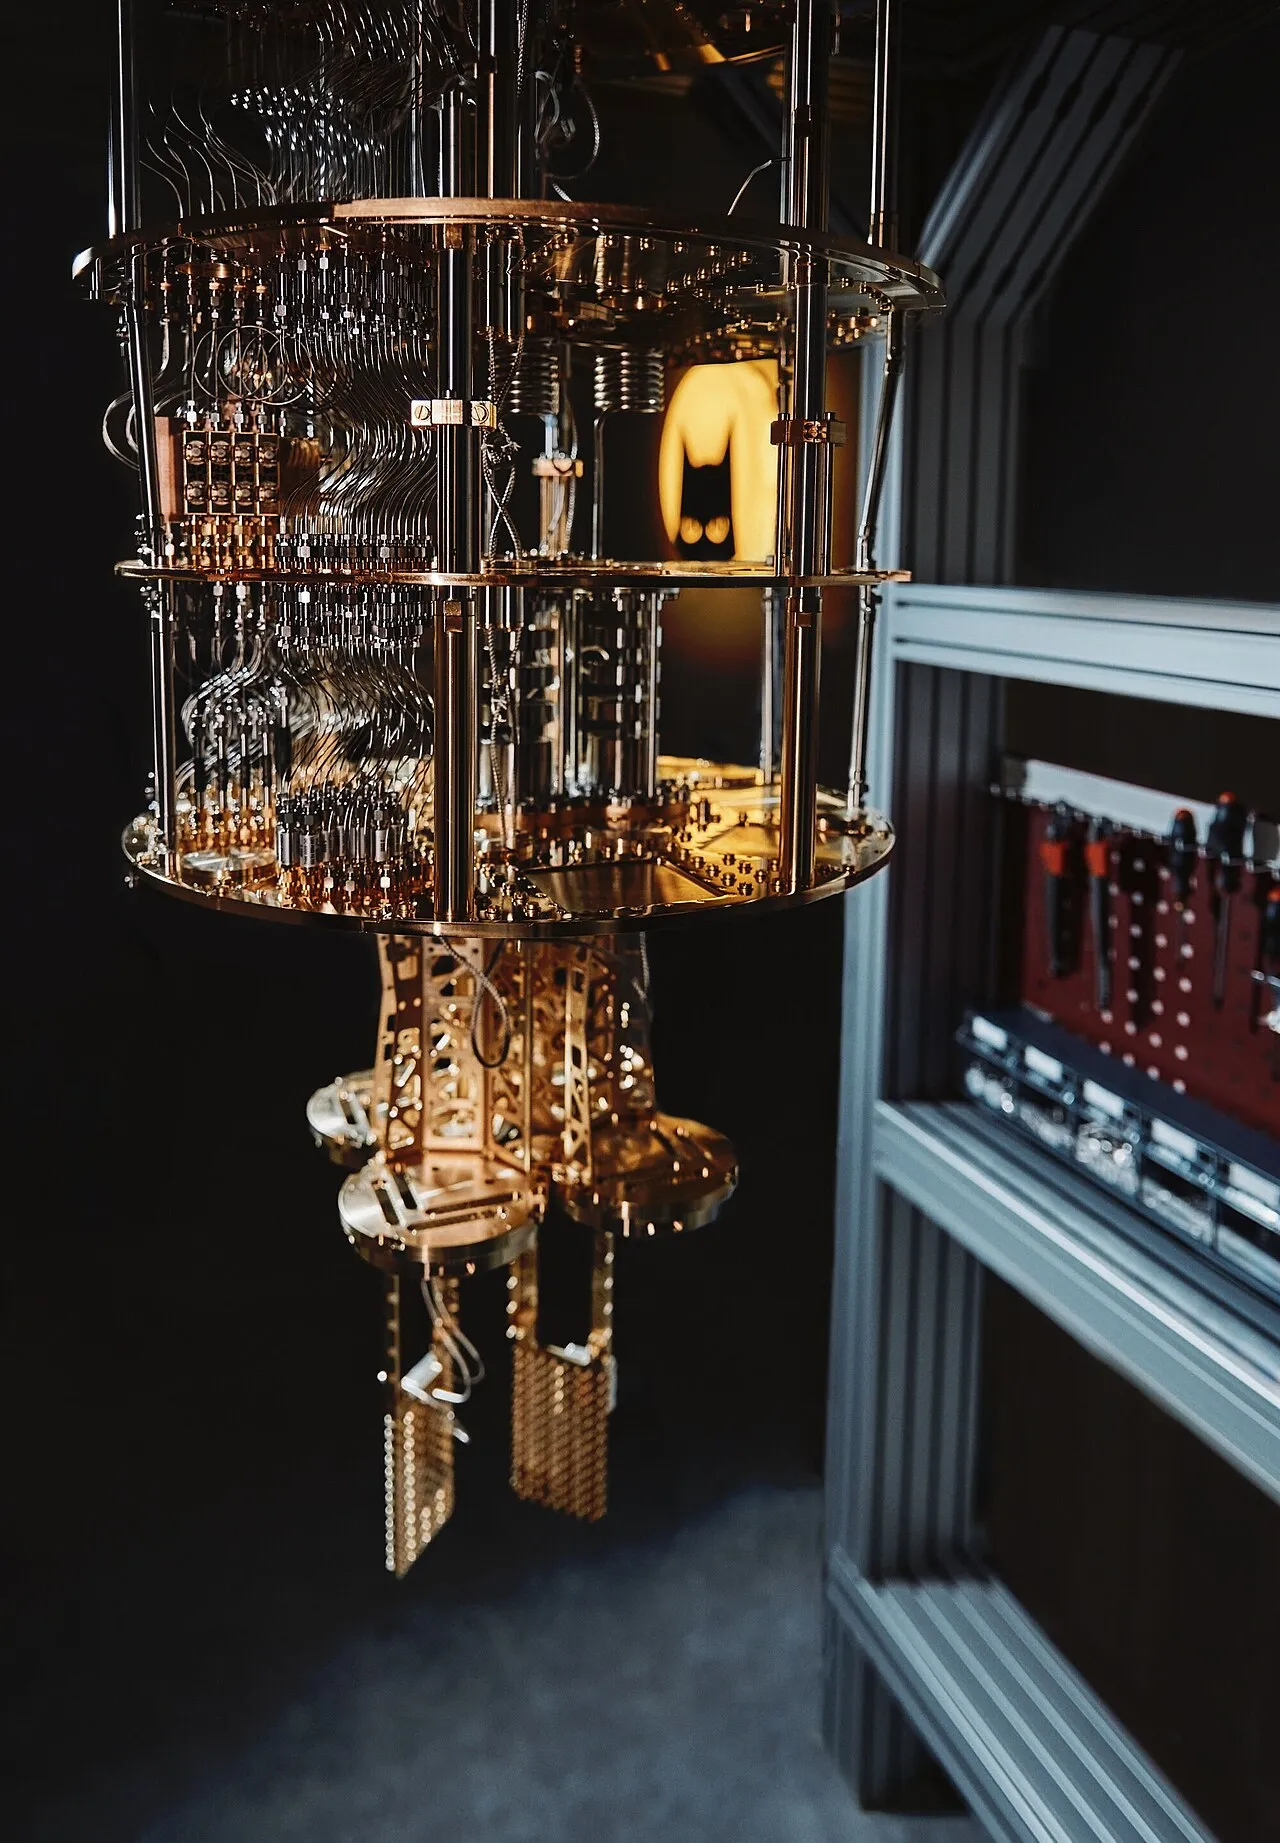
Een team van IBM Quantum in Japan, Mitsubishi Chemical, de Japanse Keio University, NVIDIA en IBM Research heeft een generatieve quantum-eigensolver (GQE) rechtstreeks op quantumhardware getraind, melden IBM, Mitsubishi Chemical, Keio University en NVIDIA. Dat gebeurde op 46 en 70 qubits van IBM’s Heron-processor ibm_kobe. Een GQE is een op transformers gebaseerd model. Het leert zelf efficiënte quantumschakelingen te genereren voor het simuleren van moleculen, in plaats van dat iemand die met de hand ontwerpt.
Volgens IBM, Mitsubishi Chemical, Keio University en NVIDIA hadden de schakelingen van de hardware-getrainde modellen bij 56 tot 70 qubits maar 64 tot 160 twee-qubit-poorten nodig. Dat is 34 tot 72 keer minder dan de 4.248 tot 6.952 poorten die de klassieke LUCJ-ansatz-methode na transpilatie nodig heeft. Die ansatz-methode is de gangbare manier om zulke schakelingen met de hand te bouwen. Minder poorten betekent minder kans op fouten tijdens de berekening. Op huidige quantumhardware zonder volledige foutcorrectie levert dat direct nauwkeurigere uitkomsten op.
IBM, Mitsubishi Chemical, Keio University en NVIDIA melden dat het trainen van de modellen ongeveer 120 miljoen fysieke hardware-shots kostte, verdeeld over vier hoofdtrainingsruns. Van de 28 testruns op 46 tot 70 qubits kwamen 27 binnen 15 milliHartree van de referentieberekening met de klassieke DMRG-methode. De mediane afwijking was 4,5 milliHartree. MilliHartree is de eenheid waarin chemici de nauwkeurigheid van energieberekeningen voor moleculen uitdrukken. Hoe kleiner de afwijking, hoe dichter de quantumberekening bij de klassieke referentie-uitkomst zit.
Het team zette de schakelingen ook in om Sn(OH)3-Me en zijn hydraten te simuleren, volgens IBM, Mitsubishi Chemical, Keio University en NVIDIA. Dat zijn minimale modellen van organotin-fotoresistmolecules voor extreem-ultraviolette (EUV) lithografie, de chipproductietechniek die de fijnste structuren in moderne processoren belicht. De getrainde modellen werkten zonder herscholing ook op deze nieuwe, niet eerder geziene moleculaire systemen van 32 tot 70 qubits. Dat generaliserend vermogen is volgens het team een aanwijzing dat de aanpak ook bruikbaar is voor moleculen buiten de trainingsset.
De bevindingen staan in de eigen arXiv-preprint van het team en zijn nog niet door vakgenoten beoordeeld. Het eerstvolgende moment om de claims te toetsen: wanneer de preprint door een vaktijdschrift wordt beoordeeld, of wanneer een ander team de methode op vergelijkbare hardware herhaalt.
Bronnen
MethodiekHoe dit artikel tot stand kwam
- Feiten bevestigd
- 4 / 4
- Bronnen
- 2
- Laatst gecontroleerd
- 12 nov 2026
- Beeld
- Foto
Dit artikel is door een AI-systeem geschreven op basis van feiten uit internationale vakmedia, publicaties van bedrijven en onderzoeksinstellingen en openbare bronnen, met de bron bij elk feit, en gecontroleerd volgens onze methodologie. De auteursnaam is een redactioneel pseudoniem. Fouten? Meld ze via de contactpagina.
Gebruikte feiten
- Een team van IBM Quantum (Japan), Mitsubishi Chemical, de Japanse Keio University, NVIDIA en IBM Research trainde transformer-gebaseerde generatieve quantum-eigensolvers (GQE) direct op quantumhardware om geoptimaliseerde schakelingen voor moleculaire simulatie te genereren, met trainingen op 46 en 70 qubits op IBM's Heron-processor ibm_kobe, aldus hun eigen arXiv-preprint. arXiv-preprint 2611.13755 (Kumar e.a.) · 12 nov 2026
- Bij 56 tot 70 qubits gebruiken de op hardware getrainde beleidsmodellen 64 tot 160 twee-qubit-poorten, 34 tot 72 keer minder dan de 4.248 tot 6.952 poorten die de klassieke LUCJ-ansatz-methode na transpilatie nodig heeft, aldus hun eigen arXiv-preprint. arXiv-preprint 2611.13755 (Kumar e.a.) · 12 nov 2026
- Het team verbruikte ongeveer 120 miljoen fysieke hardware-shots tijdens de tweede trainingsfase, verdeeld over vier hoofdtrainingsruns, en behaalde in 27 van de 28 testruns op 46 tot 70 qubits een afwijking van maximaal 15 milliHartree ten opzichte van DMRG-referentieberekeningen, met een mediane afwijking van 4,5 milliHartree, aldus hun eigen arXiv-preprint. arXiv-preprint 2611.13755 (Kumar e.a.) · 12 nov 2026
- De schakelingen werden ingezet om Sn(OH)3-Me en zijn hydraten te simuleren, minimale modellen van organotin-fotoresistmolecules voor extreem-ultraviolette (EUV) lithografie, waarbij de getrainde beleidsmodellen zonder herscholing ook werkten op deze nieuwe, niet eerder geziene moleculaire systemen (32 tot 70 qubits), aldus hun eigen arXiv-preprint. arXiv-preprint 2611.13755 (Kumar e.a.) · 12 nov 2026